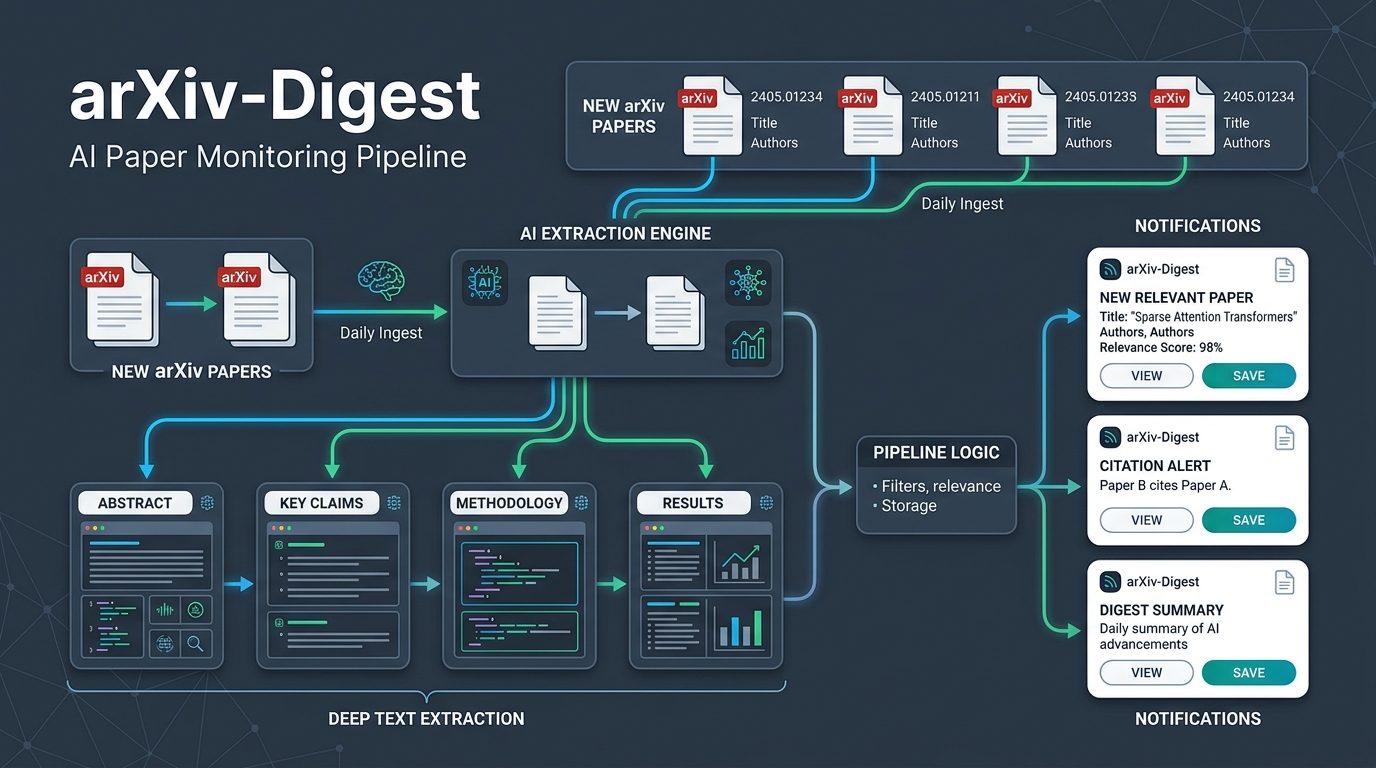
arXiv-Digest 是一个专为个人研究者与科研小组设计的自动化论文跟踪与速读流水线。它能按预设的研究领域与关键词定时抓取 arXiv 最新预印本,借助深度 PDF 文档解析与大语言模型,自动生成富文本决策卡推送到飞书群聊或私聊,并支持交互式快速精读与实验配置抽取。
项目代码开源于 GitHub: Estrellajer/arxiv-digest。
核心原则:先给出处,再给判断
传统论文速递机器人往往仅依据论文的标题和摘要(Abstract)进行关键词匹配或让 LLM 发挥,这极易引发两大问题:一是被“标题党”夸大宣传误导,二是大模型脱离实验细节产生严重幻觉。
arXiv-Digest 始终遵循事实溯源原则:
- 强制证据核验:论文的归属机构、开源代码链接、核心实验指标与参数,必须从 arXiv 元数据或实际解析到的正文页面中提取,杜绝凭空推断。
- 优雅状态降级:若遇到文档解析失败或超时,系统明确标记并降级为“仅摘要模式”,绝不虚构阅读了正文全文。
- 有限机构加分:设置合理的内容相关度门槛(如内容相关度低于 0.5 时不予加分),大厂或名校光环无法让无关水文蒙混过关。
核心功能矩阵
| 功能模块 | 核心产物 | 触发方式与交互 |
|---|---|---|
| 每日论文速递 | 包含机构、代码、核心问题、技术方案、实验结果、潜在风险与透明评分的飞书决策卡 | GitHub Actions 定时调度(工作日北京时间早上自动送达) |
| 30秒快速精读 | 核心直觉、方法分解步骤、关键消融实验、局限性分析与阅读指南 | 飞书私聊发送包含“精读”的消息,或点击速递卡下方的精读按钮 |
| 实验配置抽取 | 评测数据集、基线模型、核心超参、训练硬件、评测指标与复现缺口清单 | 飞书私聊直接发送任意 arXiv 论文链接 |
| 深度研究笔记 | 规范排版的 Obsidian Markdown 研究笔记(含分类标签与交叉引用) | 精读评定为“值得精读”后全自动生成并沉淀 |
| 多论文横向对比 | 同一学术任务或 Benchmark 下不同方案的指标参数对比表 | 手动运行 Benchmark Extractor 批量对齐 |
系统架构与轻量化工程设计
整个系统无需租用高成本的 GPU 服务器或常驻主机,完全依托现代云原生与 Serverless 基础设施构建:
- 定时调度层:由 GitHub Actions 定时触发(巧妙避开整点调度高峰,保障准时运行),拉取最新预印本并做摘要初筛。
- 全文解析层:集成开源顶尖的 MinerU 文档解析引擎,直接服务端流式处理 arXiv PDF,本地与 CI 环境均无需下载庞大文件;优先启用 VLM 高精度版面还原,自动提取首页单位与实验章节。
- 智能决策层:全面兼容任意兼容 OpenAI 接口标准的 LLM 服务(如 Qwen、DeepSeek、GPT-4o 等),按严格 Schema 结构化提取观点并透明打分。
- 即时通讯与交互层:
- 群广播采用飞书群自定义机器人 Webhook;
- 私聊双向交互由极轻量的云函数(腾讯云 SCF)接收飞书事件回调并转发 Actions,响应极快且几乎零日常运维开销。
为什么构建这个项目?
在日均数百篇预印本涌现的 AI 时代,科研人员面临着严重的“信息过载”与“文献焦虑”。arXiv-Digest 的目标不是替代人类阅读,而是充当一位严谨、诚实、永不疲倦的学术助教:在清晨用一张清晰透彻的卡片告诉你今天领域内发生了什么,在你需要时把繁复的实验配置提炼成一张明细表,将宝贵的注意力留给真正关键的科学思考。