In-Context Learning(ICL)是大模型最像「现场学习」的能力——给几个例子,它就能做新任务,无需改参数。但它不稳定、不可控,还会被示例的顺序和数量左右。这条线的一系列工作,试图把 ICL 背后那股「隐形的力」显式提取出来,变成一个可以插拔、可以调控的向量。本文顺着这条线,从 task vector 一路走到 activation steering,看我们离「理想的 ICL」还有多远。
理想的 ICL 长什么样
在动手「完善」ICL 之前,先把标尺立起来:理想的 ICL 应该是什么样?本文用一个四维标尺来衡量后续每一项工作靠拢了多少、还差什么。
我们用四个属性定义「理想的 ICL」。这不是某篇论文的官方定义,而是一把用来丈量整条技术线的尺子——后面每出现一个方法,都会回头看它满足了哪几条、漏了哪几条。
| 理想属性 | 含义 |
|---|---|
| 示例可组合(compositional) | 任务可以像向量算术一样叠加、取反、组合,而不是只能把更多示例堆进 context。 |
| 可插拔(plug-and-play) | 不依赖把 demonstration 拼成长 context;任务以一个向量的形式「注入」,推理时即插即用。 |
| 不受顺序/数量摆布 | 换示例顺序、增减示例数量,行为稳定,不被这些无关因素左右。 |
| 可控可干预 | 能定量调节任务强度(例如一个 $\lambda$),能选择性地只动该动的位置。 |
原生 ICL 几乎四条都不满足:示例不可组合(只能多塞几个)、不可插拔(必须拼进 prompt)、强烈受顺序和数量影响、且完全不可控。整条技术线的故事,就是一次次试图把这四条逐一点亮的过程——从「发现向量存在」到「脱离示例注入」,每一步都点亮了一两条,也各留了缺口。读后面每一章时,不妨回到这把尺子对照。 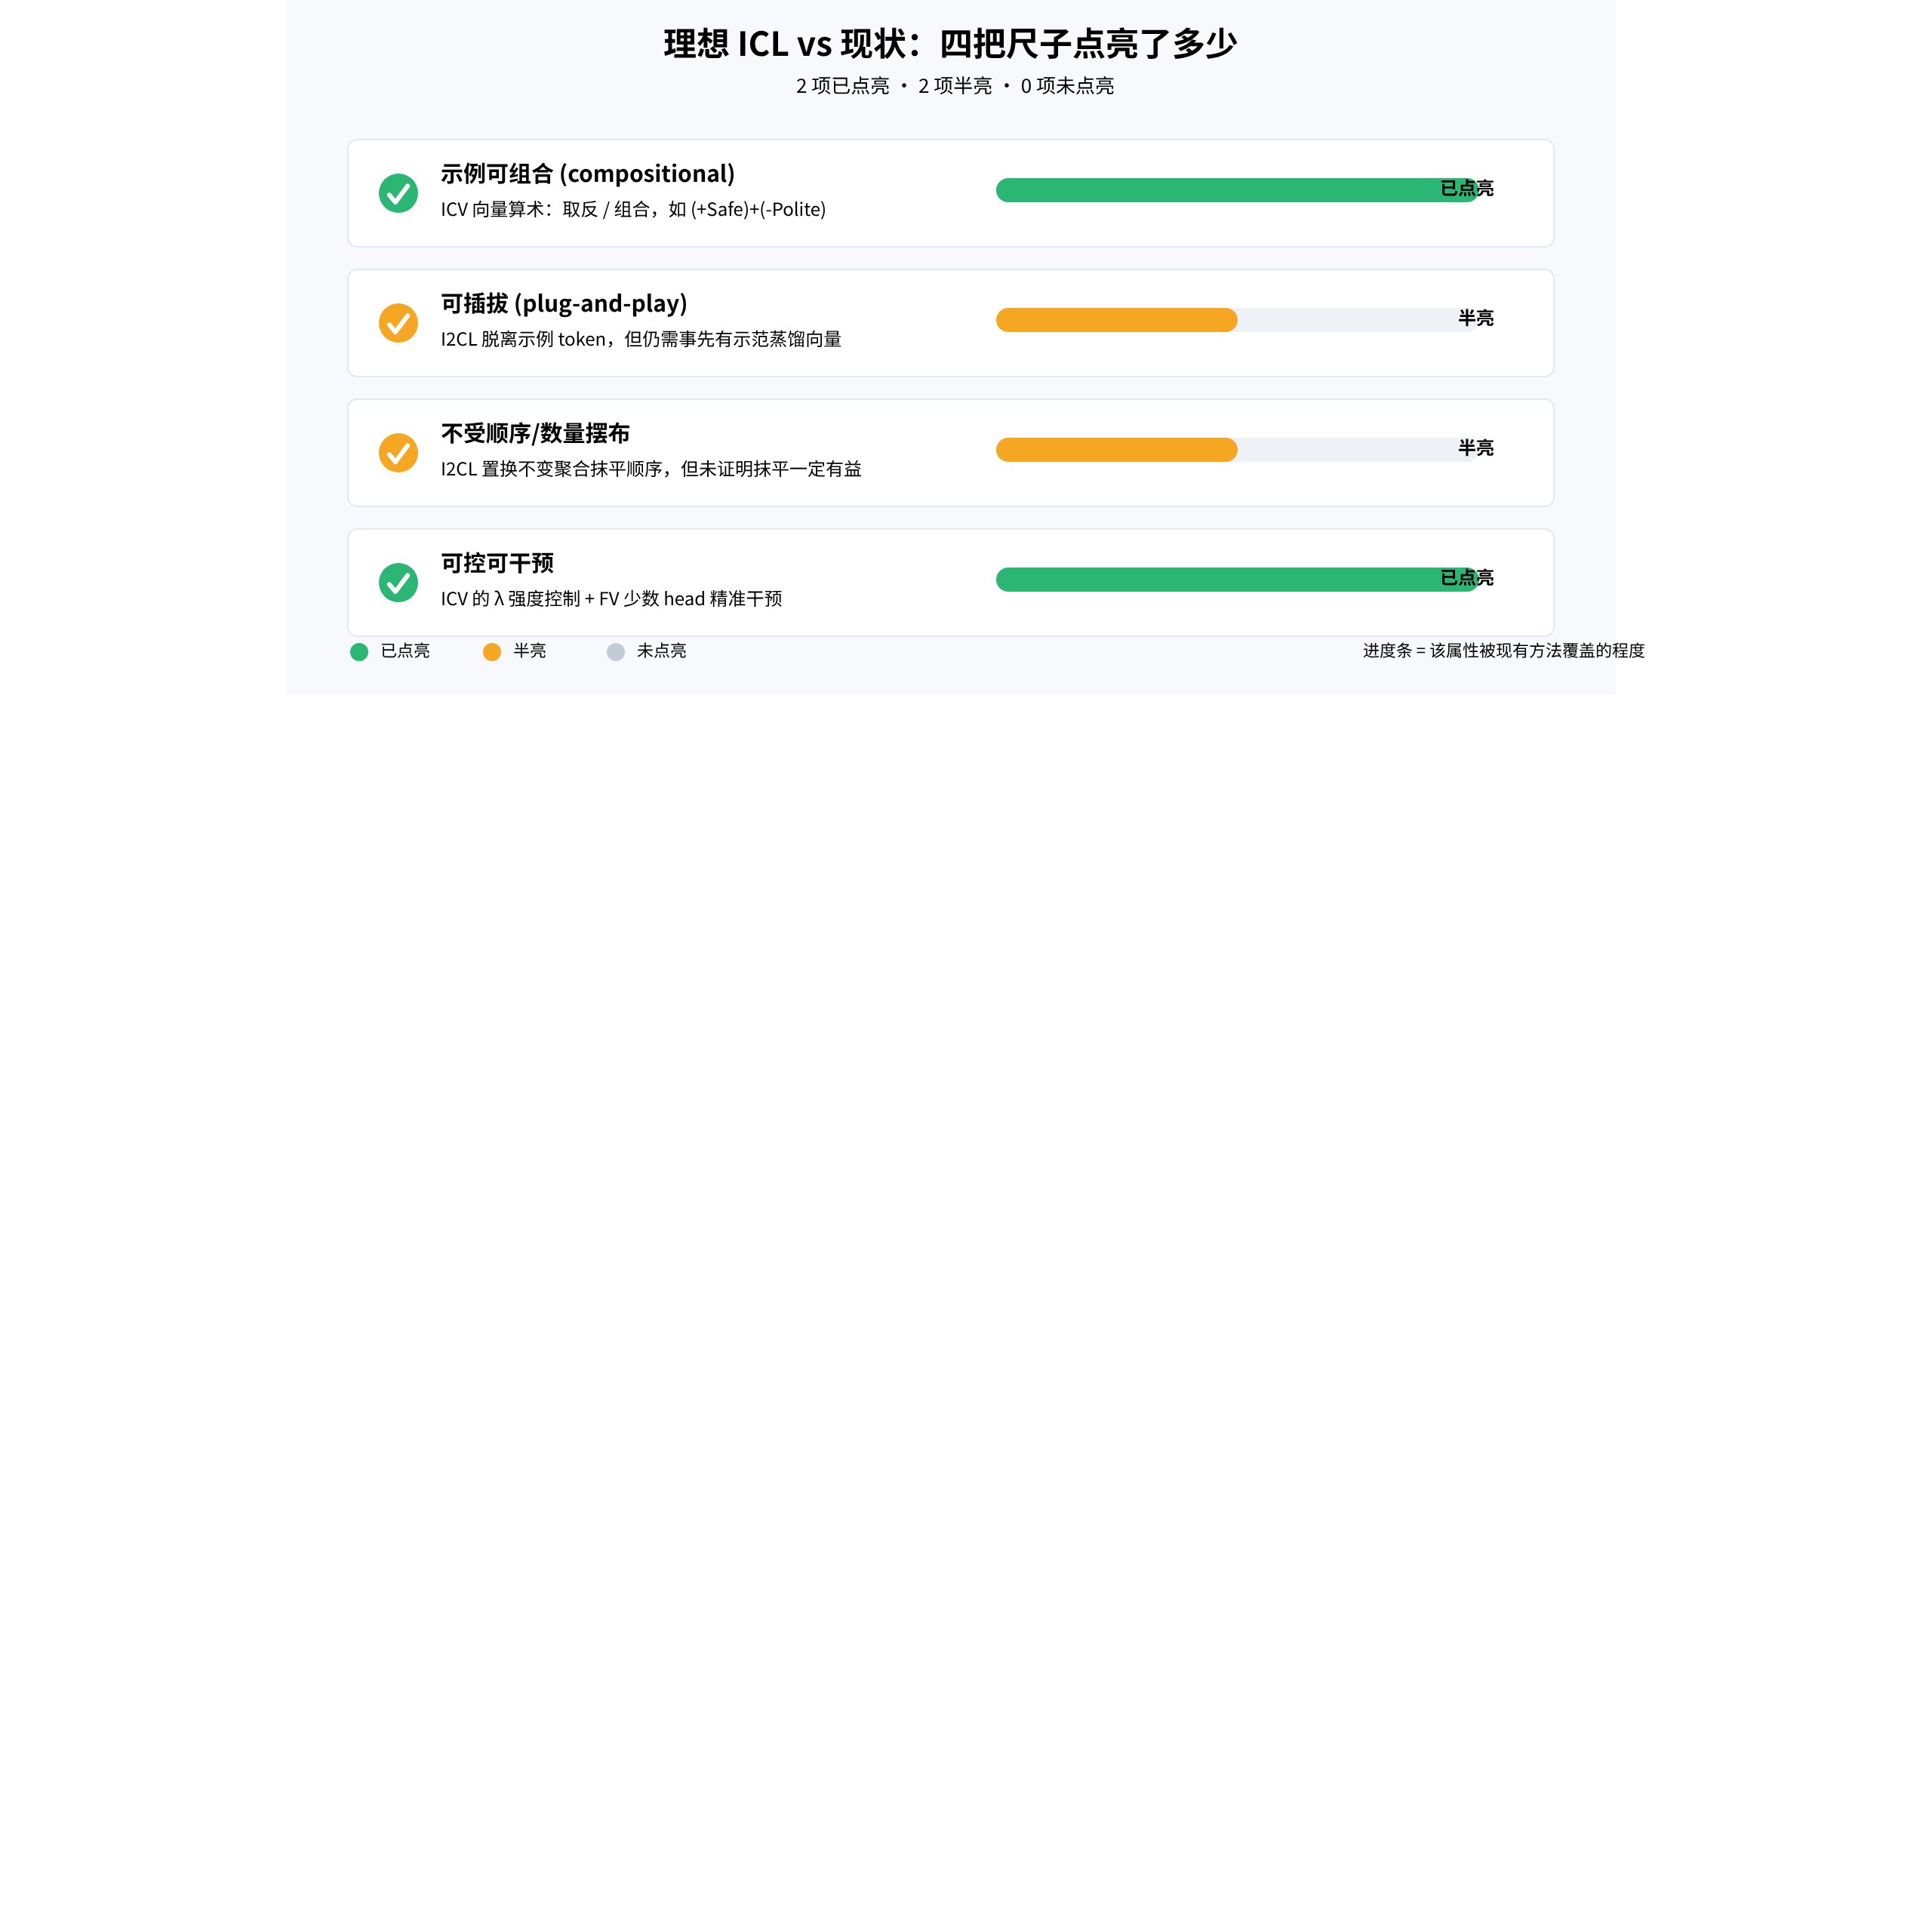
现状:ICL 其实是什么
在追问「能不能把 ICL 显式化」之前,先得说清楚 ICL 在模型内部到底做了什么。这一节是后面所有工作的共同前提。 一个被反复验证的视角是:ICL 本质上是注意力机制在每一层对 query 的隐藏状态做了一次「偏移」。当你把几个 demonstration 喂进 prompt,注意力会把这些示范里携带的任务信号搬运到 query 所在的位置,于是 query 的 hidden state 被往某个方向推了一下——这个「推」就是任务被注入的过程。模型权重一个比特没动,但 hidden state 被改写了,行为也就变了。
问题在于,这个偏移是隐式、耦合、不可控的:你看不见它推了多少、推向哪;它和示范的内容、顺序、数量纠缠在一起;你既不能定量调节它的强度,也不能选择只让某些层/某些 head 参与。这正是原生 ICL 不稳定、不可控的根源。
于是自然引出整条线的问题意识:既然 ICL 的本质是「一个加在 hidden state 上的向量」,那我们能不能把这个隐式的向量显式提取出来?提取出来之后,它是不是就可以像普通向量一样被控制、被组合、被搬到别处?这就是 task vector 这条线的起点。 这条线的每一步,其实都在回答同一个问题的某个侧面:「这个向量在哪儿?长什么样?能不能拿出来单用?」——下一步先从「它存在吗」开始。 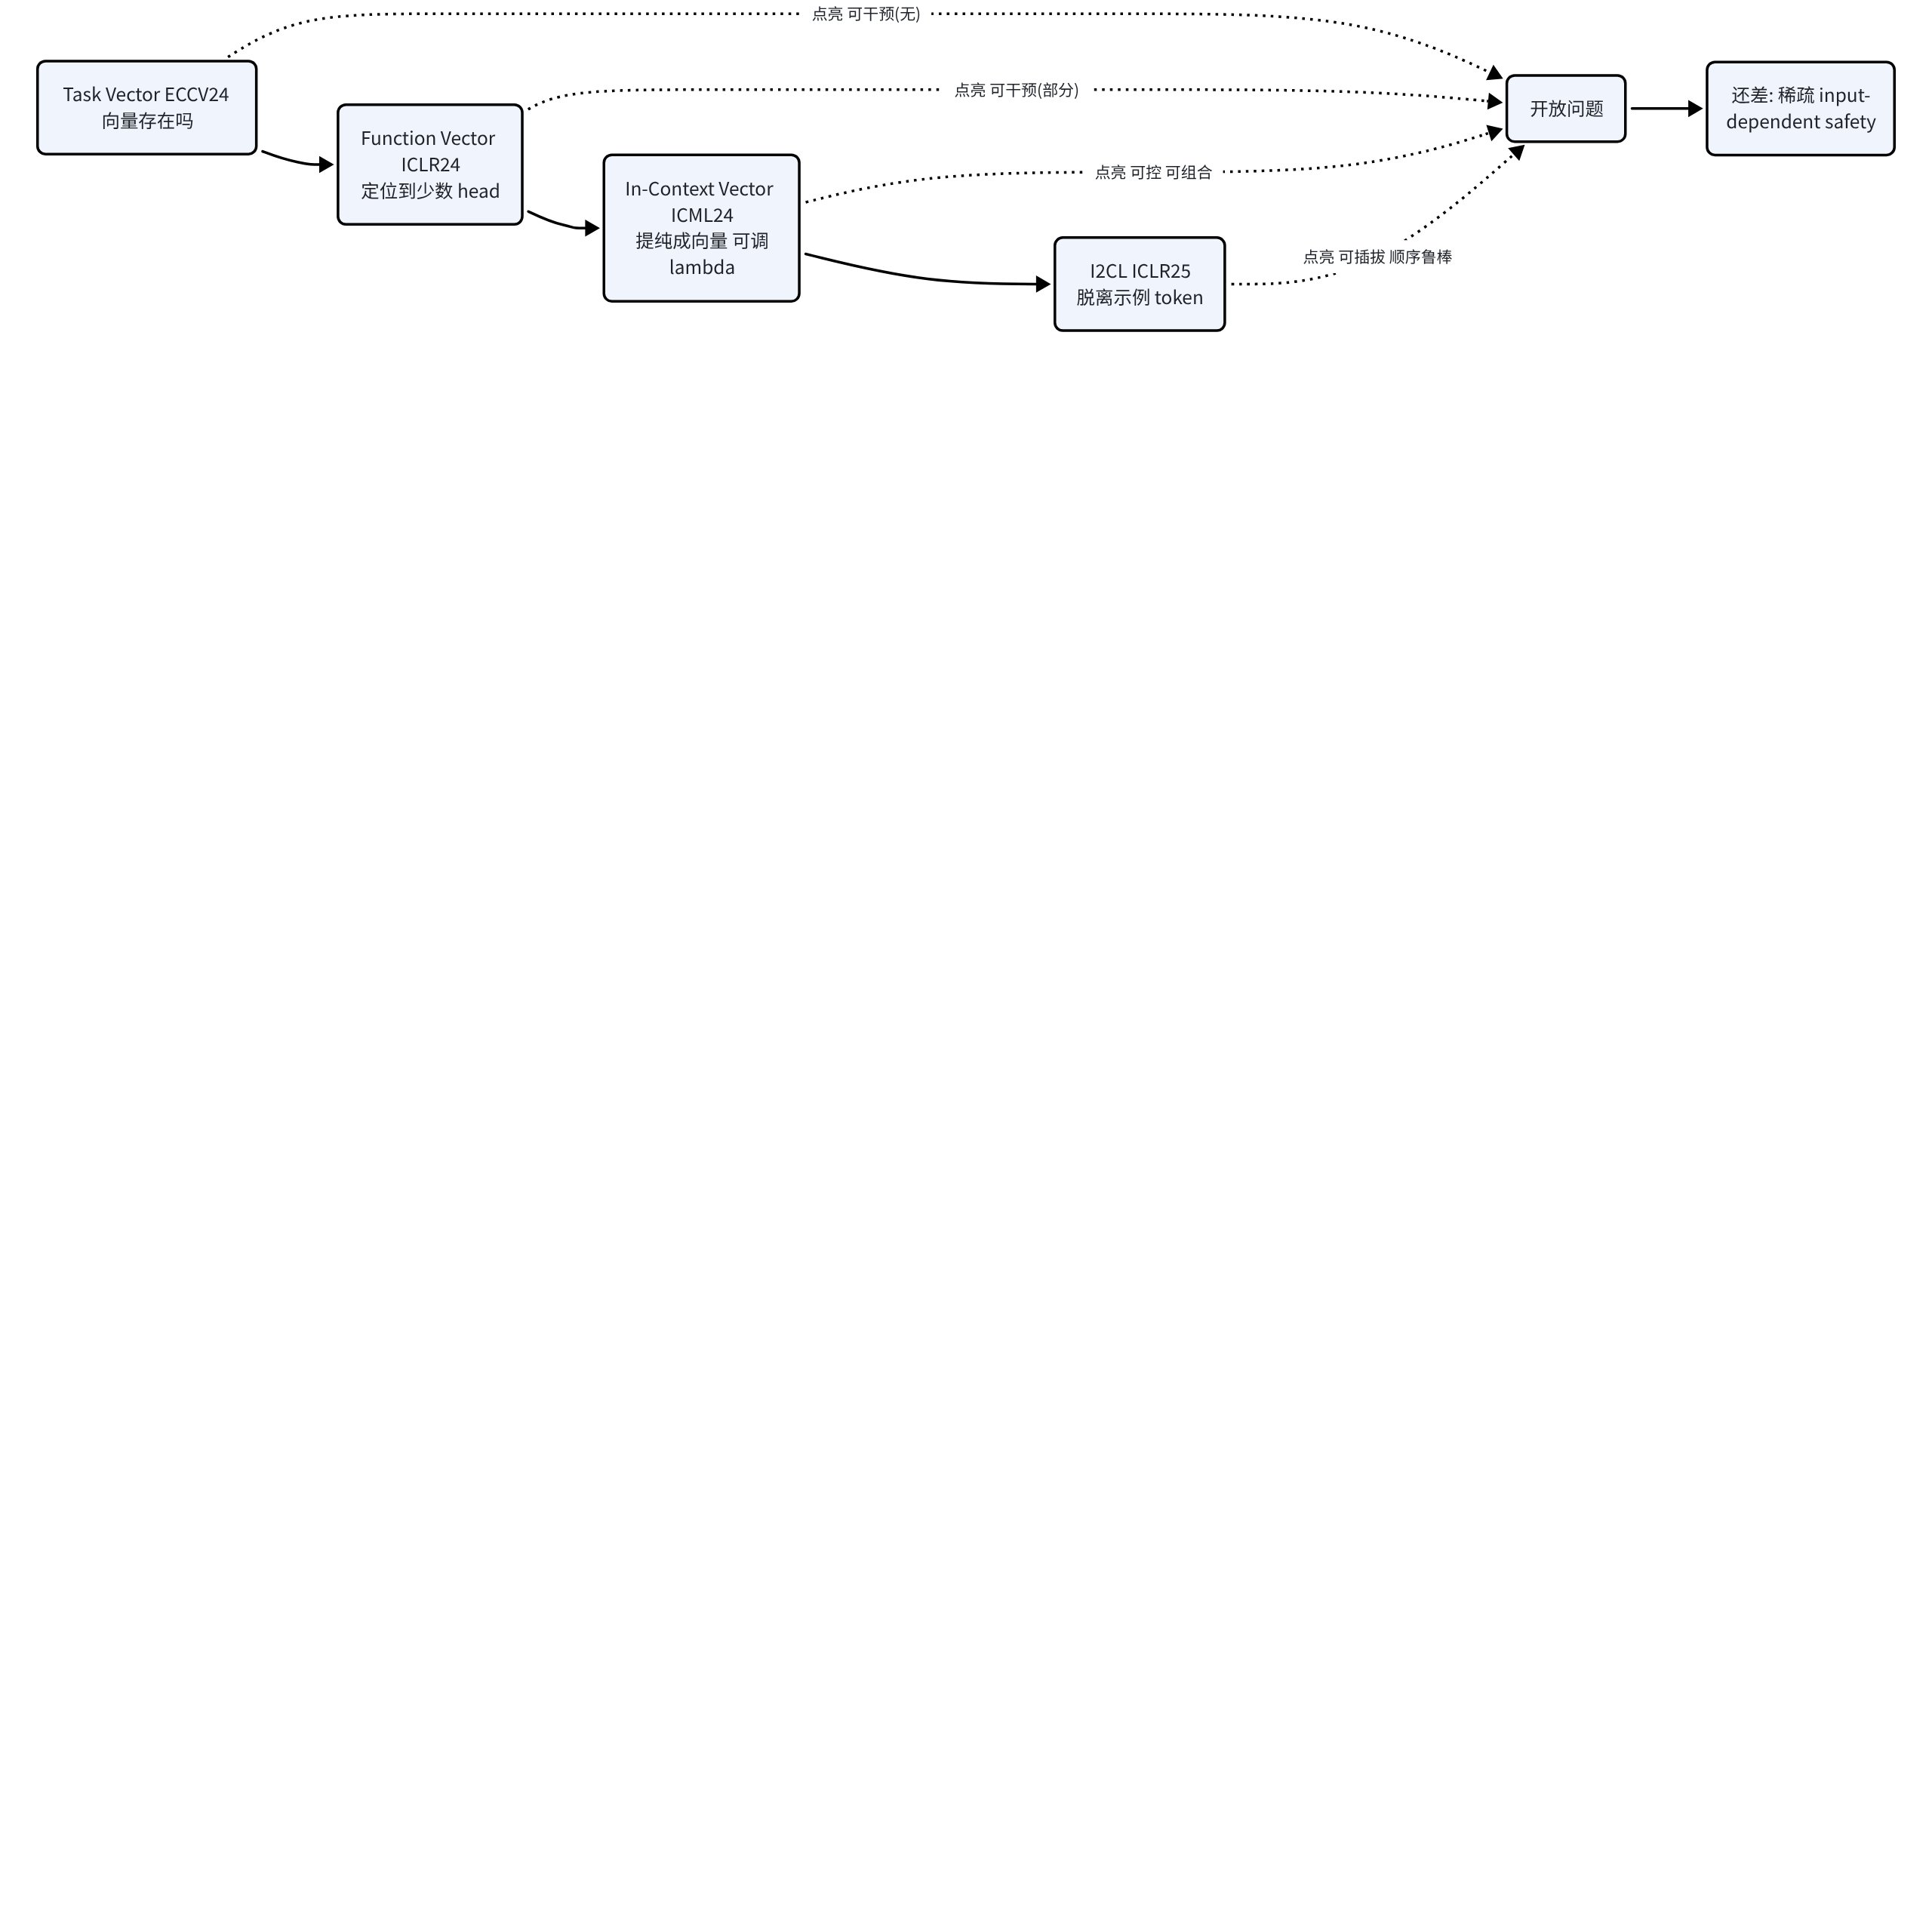
第一步:发现 task vector 的存在
结论先行:task vector 不是 NLP 的专利——它在视觉/多模态模型的 activation space 里同样存在,而且一旦找到,就能引导模型去执行对应任务。”Finding Visual Task Vectors”(ECCV 2024)做的第一件事,就是把”存在性”从假设变成实证。
这篇论文把 task vector 的存在性从 NLP 侧的猜想,变成了视觉侧的实证。作者要回答的问题很朴素:NLP 里那根神秘的 task vector,在 vision 这一侧到底存不存在?答案是肯定的——task vector 栖息在网络某几层、某几个 attention head 的 activation 之中,把它抽出来再注入回去,模型就会”认领”这个任务。一个关键的先行证据是:某些 attention head 的激活模式会按任务自然聚类,这强烈暗示 visual task vector 是有物理载体的,而不是统计噪声。 真正困难的是”去哪里读它”。NLP 和 CV 在这里有一道结构性鸿沟:NLP 模型是 autoregressive、sequential 的,最后一个 token 天然汇聚了整段 prompt 的任务信息,所以你几乎可以直接”读末位”。但 CV 里每个 patch 都有自己的 hidden state,patch 之间并非顺序处理,更麻烦的是早期工作通常只看单个 head、忽略了多 head 叠加的高阶 interaction(high-order interaction)。于是候选空间从”NLP 的一个 last token”暴涨成 $\text{layers} \times \text{heads} \times \text{tokens}$,暴力枚举完全不可行。
| 维度 | NLP(autoregressive) | CV(patch-based) |
|---|---|---|
| token 选择 | 直接取 last token,必然携带任务信息 | 每个 patch 都有 hidden state,无”末位”可言 |
| 处理顺序 | sequential,信息沿时间轴累积 | 非顺序,patch 并行展开 |
| head 交互 | 单 head 读取即可 | 需考虑多 head 叠加的高阶 interaction |
| 搜索空间 | ≈ 一个位置 | $\text{layers} \times \text{heads} \times \text{tokens}$ ↑ |
面对这个组合爆炸的搜索空间,作者把它直接 casting 成一个 RL 问题:action 是”选中哪些 head / 哪些 patch”,reward 是下游 task accuracy。RL 之所以合身,原因有三——空间是离散的选择、组合数极大、而且唯一可用的监督信号是”任务做得好不好”,这恰好匹配 policy gradient 这类试错搜索范式。学到的 policy 本质上就是一个”去哪里取 task vector”的选择器。
它解决了什么、又留下什么:这篇工作 confirm 了 task vector 的存在性,并给出一个能 work 的 selection 方法,但代价不低——RL 搜索开销大,而且得到的只是一个”按输入逐次搜索”的选择策略,并不是一根干净、可跨样本复用的向量本身。这个缺口正是后续两章的出发点:FV 把搜索范围收窄到少数 head,ICV 则更进一步,直接抽出一根可以搬移的 clean vector。
第二步:定位到少数 attention head
上一章确认了 task vector 确实存在,却把”它究竟藏在哪儿”这个问题悬置了——一个 transformer 有 layers × heads × tokens 这么多候选位置。Todd et al. (ICLR 2024) 给出了一个相当锐利的回答:在 LLM 中,任务被压缩成一个紧凑的 function vector,而只有极少数 attention heads 负责搬运它。
function vector 并不是一个抽象概念,它是 transformer hidden state 中一个实实在在的向量,代表一个从 input 到 output 的函数。当模型做 ICL 时, demonstrations 所蕴含的”做什么变换”被提炼进这个向量里;只要它出现在 residual stream 的合适位置,模型就能完成对应任务——即便 demonstration 本身被拿掉。这正是这篇论文的第一个核心发现。 第二个发现更关键,它把”哪里”从几千个 head 缩小到了个位数。研究者用 causal intervention 的方式逐个探测 attention head,发现只有极少数 attention heads 在传播任务信息。这些 heads 有两个鲜明的几何特征:一是它们集中在 transformer 的中间层(middle layers),既非浅层也非末层;二是它们主要关注 demonstration 的 output token,而非 input 或 format token。换言之,模型在中间层把 demonstrations 的输出语义收拢起来,通过这几个 head 注入到 last-token 的 hidden state 上。
| 维度 | function vector 的定位 | 含义 |
|---|---|---|
| 是什么 | hidden state 中的一个向量 | 编码 input→output 的函数 |
| 由谁搬运 | 极少数 attention heads | 非全部 head 参与 |
| 在哪一层 | middle layers | 中间层,非首末 |
| 关注什么 | demonstration 的 output token | 而非 input/format |
第三个发现把前两个串成了因果闭环:仅对这少数几个 head做干预(intervention),就能复现 ICL 的任务行为。这说明任务信息不是弥散在整张网络里的,而是被这条窄通道集中承载——少即够用。用一个粗略的类比:如果说残差流是高速公路,那么大部分 head 只是路边的噪声,真正把”任务”这个货送到 last-token 的,是中间层几条专用的匝道。
Q1:为什么不每个任务配一套独立的 attention head,而要跨任务共享?
Q2:为什么承载任务信息的是 attention head,而不是 MLP?
局限与交接:function vector 把位置从”整网”收窄到”少数中间层 head”,但仍有一条尾巴——它只在 demonstration 存在时被激活,干预也只施加于少数 head。换句话说,FV 告诉我们”任务藏在哪儿”,却没有给出一个可以脱离 in-context example、干净注入的向量。下一章的 ICV 会更进一步:直接抽出一个干净的 task vector,并把它应用到所有 layer 和所有 position——从”定点干预”走向”全场注入”。
第三步:提纯成向量并显式干预
核心洞察:ICL 本质上是注意力机制在每一层对 query 的 hidden state 做的一次”偏移”。In-Context Vector(ICV)把这个原本隐式、分散在 attention 里的偏移,提纯成一个显式、可控的向量,直接加到 residual stream 上——不再需要把 demonstration 塞进 context。
前两章我们确认了两件事:task vector 确实存在(第一章),而且它往往只藏在少数几个 attention heads 里(第二章)。但 Function Vector 有一个绕不开的约束——它依然需要把 demonstration samples 摆在 context 里,让模型自己去”读”出任务。一个自然的问题浮出来:能不能把 ICL 施加在 query 上的那次”偏移”直接抽出来,作为一个显式的向量?这就是 ICV(In-Context Vector,ICML 2024)的回答。 ICV 的出发点是一个重新理解 ICL 的视角:ICL 不是在参数里改写了模型,而是在每一层、每一个 token 位置上,通过 attention 把 query 的 hidden state 朝某个方向推了一下。这个”推”的方向,就是任务本身。既然如此,与其让 attention 每次重新算一遍这个偏移,不如把它显式地估计出来,直接加回到 residual stream 上。
两条提取路径:从 demonstration 里”提纯”偏移向量
ICV 的提取分两条路,对应有没有配对数据。
路径 A:配对数据
路径 B:无配对数据
路径 A 的关键公式很简洁,在每一层 $\ell$ 上:
$\Delta H^\ell = h^\ell(y) - h^\ell(x)$ 对多组 demonstration 收集到 $\lbrace \Delta H^\ell_i \rbrace$ 后,做 PCA 取第一主成分,即该层的 ICV $v^\ell$。
这里的直觉是:$h(y) - h(x)$ 量化了”从输入到输出,模型内部状态需要往哪个方向挪动”,而 PCA 的第一主成分把这些零散的差值收敛成一条最一致的”任务方向”。
干预方式:全层全位置 + 缩放因子 λ
提取出 ICV 之后,怎么用?这里出现了 ICV 与 FV 最关键的对比,必须说清楚。
| 维度 | Function Vector(第二章) | In-Context Vector(本章) |
|---|---|---|
| 干预范围 | 仅少数关键 attention heads | 所有层 + 所有 token 位置 |
| 向量来源 | 对比有/无 demo 的激活差,取少数 heads | 配对差值 $\Delta H$ 的 PCA 第一主成分,或对比梯度 |
| 可控性 | 离散,靠增删 heads | 连续,通过 $\lambda$ 定量调节强度 ↑ |
| 是否仍需 demo in-context | 需要 | 提取阶段需要,推理阶段不再需要 |
注意:干预范围是 ICV 与 FV 的分水岭。FV 讲究”稀疏”,只在几个 heads 上动手;ICV 反其道而行——应用于 Transformer 的所有层、所有 token 位置时效果最显著。代价是不够稀疏高效,换来的是更平滑的可控性。
而 ICV 真正吸引人的地方,是这个缩放因子 $\lambda$(step size)。把 ICV 以 $\lambda \cdot v^\ell$ 加到第 $\ell$ 层的 hidden state 上,$\lambda$ 越大,任务执行强度越强。论文给了一个直观例子:做文本脱敏(PII redaction)时,增大 $\lambda$ 直接提升脱敏力度——从偶尔漏打到几乎全覆盖,是一条可调的旋钮,而不是 on/off 开关。
Word2Vec 式的线性代数:取反与组合
更 surprising 的是,ICV 在 latent space 里展现出类似 Word2Vec 的线性代数性质。这意味着 task vector 不只是一个”指示牌”,而是一个真正可做向量运算的语义方向。
- 取反(negation):把 ICV 反向叠加,即 $-v$,可以实现”任务取反”——例如用”正式→非正式”的 ICV 反向施加,就能把正式语体转回非正式。
- 组合(composition):通过向量加减法复合多个任务。最经典的例子:
$(+\text{Safe}) + (-\text{Polite})$ = “内容安全但语气粗鲁”的回复 把”安全”方向的 ICV 正向叠加、把”礼貌”方向的 ICV 负向叠加,模型就会产出一份既过滤了有害内容、又故意带点粗鲁语气的回答。这种可组合性是原始 ICL 完全给不了的——你没法在 prompt 里同时说”要安全”和”要不礼貌”还指望模型精确拿捏。
小结:离理想 ICL 还差一步
ICV 把 ICL 的隐式偏移提纯成了显式向量,换来两个理想 ICL 的关键属性:可控性($\lambda$ 定量调强度)与可组合性(向量加减做任务复合)。但它仍有两处不够:①提取阶段仍依赖 demonstration;②干预所有层所有位置,不够稀疏高效。
下一章的 I2CL 会接着这条线往下走——它干脆把对 demonstration token 的依赖也去掉,让 ICL 的”偏移”以更彻底的方式被显式化。ICV 已经把”向量”和”旋钮”拿到了手,I2CL 要解决的是”还要不要那些 demo token”的问题。
第四步:彻底脱离示例 tokens
前两步告诉我们:task vector 存在(ch1),而且住在少数中间层 attention head 里(ch2);第三步 ICV 把它提纯成一个可调 λ 的向量,还获得了线性代数式的可组合性。但它们都有一根共同的尾巴——还得把 demonstration 拼进 context 才能提取向量。这一步要砍掉这根尾巴:能不能彻底不依赖显式示例 token,只用一个向量就把任务「注入」进去?Implicit In-Context Learning(I2CL)的回答是:可以。
I2CL 的核心动作是把示范样本转化成 context vector,然后在 activation space 直接做 intervention,从而彻底摆脱对显式 demonstration tokens 的依赖。换句话说,示例不再需要跟着 query 一起进 prompt——你只需要事先把任务「蒸馏」成一个向量,推理时把它加到对应位置即可。这一步直接命中了理想 ICL 的「可插拔」属性。 它由四个设计拼成,每一块都对应一个明确的取舍:
| 设计 | 在做什么 / 为什么 |
|---|---|
| 独立向量化 | 不同于 ICL 把示范与 query 拼接,I2CL 为每个示范对 $(x_i, y_i)$ 独立提取向量表示,避免示范与 query 互相污染。 |
| 末位 token 取激活 | 收集每个示范样本在 MHA 和 MLP 模块中最后一层 token 位置(end residual stream)的输出激活值,作为该示范的向量。 |
| 置换不变聚合 | 对所有示范样本的向量组件取算术平均,生成统一的 context vector $v$。实验证明这种聚合对示范的选择和顺序都鲁棒。 |
| noisy self-calibration | 用基于梯度的优化,在注入时引入高斯噪声,最小化示范标签的 perplexity,自动估计线性系数 $\lbrace \lambda, \beta \rbrace$。 |
其中最关键的两个 insight 是「置换不变聚合」和「noisy self-calibration」。前者回答了一个一直悬而未决的问题——示例顺序到底重不重要?I2CL 用「算术平均」这步操作直接把顺序信息抹平,并且实验显示这样做不仅不损失、反而更稳。这意味着:至少在 I2CL 的设定下,示例顺序对任务表征本身是冗余的,顺序带来的波动被平均掉了。后者则把「λ 该设多大」从人工调参变成了可自动估计的量。 还有一个有意思的副产物——task ID 属性。校准后的线性系数 $\lbrace \lambda, \beta \rbrace$ 可以作为天然的 task IDs:语义相似的任务(如 SST-2 和 MR),其系数向量在潜空间里分布更接近。这天然支持迁移学习——用已有任务的锚点去帮新任务。
靠拢了哪个理想属性:示例可插拔(不依赖拼接 context)+ 对顺序鲁棒(平均聚合抹平顺序)。还差什么:它仍要「事先有一批示范」来蒸馏向量,并非无中生有;而且注入仍是逐层加向量,不是稀疏、不是 input-dependent。这为后续多模态和开放问题埋下伏笔。
多模态的特殊难题
前面四步主要在 NLP 的地盘上讲故事——autoregressive、有明确的 last token、可以挑 head。一旦把同样的思路搬进多模态(MLLM),事情立刻变难:图像 patch 不像 token 那样有天然顺序,每个 patch 都有 hidden state,而且视觉与语言的交互跨越 modality。下面三篇是这条线在多模态上的代表,分别走「many-shot 加大示例量」「新增一个模块模拟 task vector」「只在敏感 head 上插入」三条路。
| 论文 | 核心做法 | 是否 input-dependent | 思路定位 |
|---|---|---|---|
| Multimodal Task Vectors NeurIPS 2024 | TV 的多模态版本,用大量示例(many-shot)让多模态 ICL 起作用,把 task vector 扩展到图文。 | 否(依赖示例拼接) | 「把 NLP 的 task vector 搬过来 + 加示例量」 |
| Mimic In-Context Learning CVPR 2025 | 类似 S-Prompts,新增一个模块来模拟 task vector,做到 input dependent。 | 是 | 「让向量随输入变化」 |
| Sensitivity-Aware Task Vectors AAAI 2026 | 对 vector 聚类求均值,测量每个 attention head 在有无 in-context 示例时的激活变化幅度,只在对上下文最敏感的 head 上插入 task vector。 | 部分(细粒度选择) | 「更细粒度地控制插入位置」 |
三篇可以看作对同一个难题的三种回应:many-shot 靠「量」压、Mimic 靠「新模块」做 input-dependent、Sensitivity-Aware 靠「挑敏感 head」做细粒度控制。它们都没有正面回答「多模态下理想的 task vector 该长什么样」,而更接近在已有的 task vector 框架上做多模态适配与刷点——这也正是后面「能否统一」这个开放问题的来源。
统一视角:都是 dynamic weight update
走到这里,有必要退一步,把 task vector / function vector / ICV / I2CL 这条线放进一个更大的框架里看。ZJUNLP 的工作「Why Steering Works」给出了一个统一视角:LoRA、local weight、steering vector 其实都可以看作 dynamic weight update——它们都在「改写模型行为」,只是改的位置和方式不同。
参数空间更新LoRA、local weight:改的是模型参数(权重)。偏向 fine-tuning 场景,改完是持久的。
激活空间干预steering vector(含 task vector / FV / ICV / I2CL):改的是激活值。偏向 test-time scaling,即插即用、可逆。
这个统一视角要处理的,是一个普遍存在的 trade-off:enforcing the target concept(强化目标概念)与 preserving task validity(保持任务有效性)之间的折中。你要把模型往某个方向「推」,推得太轻没效果,推得太重又会破坏它本来能做的任务——这就是所谓的「折页损失」。steering vector 因为只动激活不动参数,天然处在这条 trade-off 的「轻量」一端。
这里还隐含一个定位差:steering vector 是 test-time scaling 的视角,而 LoRA / local weight 更多用于 fine-tuning。把它们统一进「dynamic weight update」不是为了抹平区别,而是说明:ICL 的 task vector 本质上和 fine-tuning 是同一件事的两个端点——一个在激活空间临时改写,一个在参数空间持久改写。理想 ICL 的「可插拔」属性,恰恰要求我们待在激活空间这一端。
五个开放问题
前三步把「向量存在→定位→提纯→脱离示例」的链路走完了,但走完不等于走通。下面五个问题,是这条线上仍未解决、且我认为值得继续挖的点。每个给出背景、假设、可能的技术路径。
Q1 多模态 backbone 是否影响 vector 方法,能否统一?有 blog 表明不同 backbone 对 steering 方法确实有影响。如果 backbone 差异显著,那么「多模态下找统一的 task vector 方法」本身就值得作为一个 contribution。路径:跨 backbone 做相同的 head/token 干预实验,量化 backbone 带来的方差,再判断统一是否可行。
Q2 input-dependent vs independent 的 Paretoinput-dependent 的方法(如 Mimic ICL)效果更好但要额外模块、更贵;input-independent 的(如 ICV)便宜但表达力弱。能不能像开篇那篇 Unified View 一样,在这两者之间做到一个 Pareto optimal——既随输入变化、又保持推理高效?路径:把「输入条件」压缩成一个低维调制信号,只调 steering 的方向/强度而不重新算整张 forward。
Q3 稀疏叠加假设可以大胆假设:Multimodal LLMs represent task behavior as a sparse superposition of a small set of reusable latent task directions.(多模态 LLM 把任务行为表示为少量可复用 latent task direction 的稀疏叠加。)若成立,就能把任务拆成几个正交的 task direction,且不用计算所有 hidden forward,推理效率天然高。路径:在多个任务上做 dictionary learning / sparse coding,看能否学到一组共享的、可组合的方向字典。
Q4 示例顺序是否携带信息?一个反直觉的矛盾点:视觉似乎会影响注意力分数,示例顺序也会影响输出——那么学到的 input-independent vector 真的好吗?更精确的问题:如果消除顺序对输出的影响,对当前任务是有益还是有害?同时对其他任务的 transfer 是有益还是有害?I2CL 的平均聚合默认了「顺序冗余」,但这个默认值得单独验证。参考《Calibrate Before Use》对 ICL 校准的思路。路径:人为打乱/排序示例,分别测量当前任务精度与跨任务 transfer。
Q5 safety 视角下是否存在 Pareto optimal?考虑任务的泛化线可能没有意义,但如果换成 safety 视角,就可能存在一个 Pareto optimal——即在「任务有效」与「安全可控」之间的最佳折中。这是把 task vector 从「刷点」拉向「可控对齐」的一个方向。路径:在 steering 强度 λ 的轴上扫,刻画任务精度与安全指标(如越狱成功率)的 Pareto 前沿。
这五个问题之间不是孤立的:Q3 的稀疏叠加若成立,会给 Q2 的 Pareto 提供高效实现;Q4 的顺序实验会反过来检验 Q3 里「方向正交」的假设;Q5 则把前四个的结论从「效果」迁移到「安全」。它们共同指向一个更大的问题——我们到底离理想的 ICL 还有多远。
结语:我们走到哪了
回到开头那把尺子。这条线走下来,理想 ICL 的四条属性被点亮了多少? 从「发现 task vector 存在」(ch1)到「定位到少数 head」(ch2),再到「提纯成可调 λ 的向量并拿到线性代数式组合性」(ch3),最后到「彻底脱离示例 token 注入」(ch4)——我们一步步点亮了可控可干预和示例可组合,并在 I2CL 那里点了一半的可插拔和不受顺序摆布。但每一步也都留了缺口:ICV 仍要示范来提取向量、干预不稀疏;I2CL 抹平了顺序却还没证明「抹平」本身一定有益;多模态那三条路更接近适配与刷点,而非重新定义 task vector。
所以,「我们离理想的上下文学习还有多远?」——答案不是某个百分比,而是一张半亮的清单:可控与组合性已经摸到,可插拔与顺序鲁棒性各点亮了一半,而稀疏叠加、跨任务统一、与 safety 的权衡仍是开放问题。理想 ICL 不是一个终点,而是一个被这把尺子不断重新定义的前沿。离它多远,取决于你愿意点亮清单上的哪一格。